人人都说过「DDP 会 all-reduce 梯度」「MoE 的瓶颈在 all-to-all」,但从这句话到真正算清一次通信要搬多少字节、为什么 ZeRO-3 用 AG+RS 而不是 AR,中间隔着一层没人细讲的词汇表。这篇把这层词汇表补齐:点对点 + 八个集合通信原语,每个讲清四件事——语义、每卡通信量、torch.distributed 里怎么写、在 LLM 训练/推理框架里长在哪。算法内部(ring/tree 逐步推演、NCCL 机制、重叠调度)留给下一篇。所有代码在 PyTorch 2.9、gloo 后端、4 进程下实测通过——CPU 就能跑,不需要 GPU。
Table of contents
Open Table of contents
一、预备:两条通信路径
设集群有 个进程(rank),每个 rank 绑一张卡。跨卡数据移动只有两条路径:
- 点对点(p2p):一个 rank 发、一个 rank 收。
Send/Recv。 - 集合通信(collective):一组 rank 共同参与一个 coordinated 操作,每个成员都调用同一个接口。剩下的八个原语全是这类。
工程上这两条路径都主要由通信库代理——NVIDIA 卡上是 NCCL(AMD 对应 RCCL),PyTorch 的 dist.init_process_group(backend="nccl") 底下就是它。开发调试时用 CPU 后端 gloo 也完全够:原语语义一致,本文所有示例就是这么跑的。NCCL 本身只提供原语,不提供并行策略;所有并行策略最终都被编译成这九个词的序列。这也是读分布式训练代码的方法:先把框架 API 还原成原语序列,再算每个原语的字节账。
记号: = 参与操作的逻辑张量总大小(字节), = 链路有效带宽,每卡起始持有 (分片)或 (副本)。
二、Send/Recv:点对点
最简单的原语:rank 把一块数据发给 rank ,仅此而已。用 tag 区分同一对 rank 之间的多条逻辑流:
act = compute(x) # 本 stage 的输出激活if rank > 0: dist.send(act, dst=rank - 1, tag=10) # 激活发下游g_act = torch.empty_like(act)if rank < world_size - 1: dist.recv(g_act, src=rank + 1, tag=20) # 梯度从下游回来同步版 send/recv 会阻塞到对端就绪;流水线实现里用异步版 isend/irecv 拿到 handle,把传输和计算重叠起来(1F1B 调度的本质就是管理这些 in-flight 的 handle)。
它承载了两大 LLM 场景:
流水线并行(PP)。模型按层切成 段,每段住一个 rank。microbatch 的激活值沿着流水线向下传、反向时梯度往回传——相邻 stage 之间全是 Send/Recv。1F1B 等调度只是在安排这些点对点发送的时序,通信本身没有变。
PD 分离推理。Prefill 和 Decode 部署在不同机器上时,prefill 结束后要把该请求的 KV cache 搬去 decode 侧。这个传输不走 NCCL 集合通信,而是点对点 RDMA——Mooncake、vLLM/SGLang 的 disagg 传输层都是这个思路:KV 是「这一个请求的」数据,只对固定的 decode 实例有意义,集合通信反而低效。
点对点的好处是精确:发多少、发给谁、什么时候发,全部可控。代价是所有编排逻辑(路由、分块、同步)都要自己写——这正是集合通信存在的原因。
三、一对多与多对一:Broadcast / Scatter / Gather / Reduce
这四个原语共享一个结构:有一个特殊的 root rank,通信以它为中心。
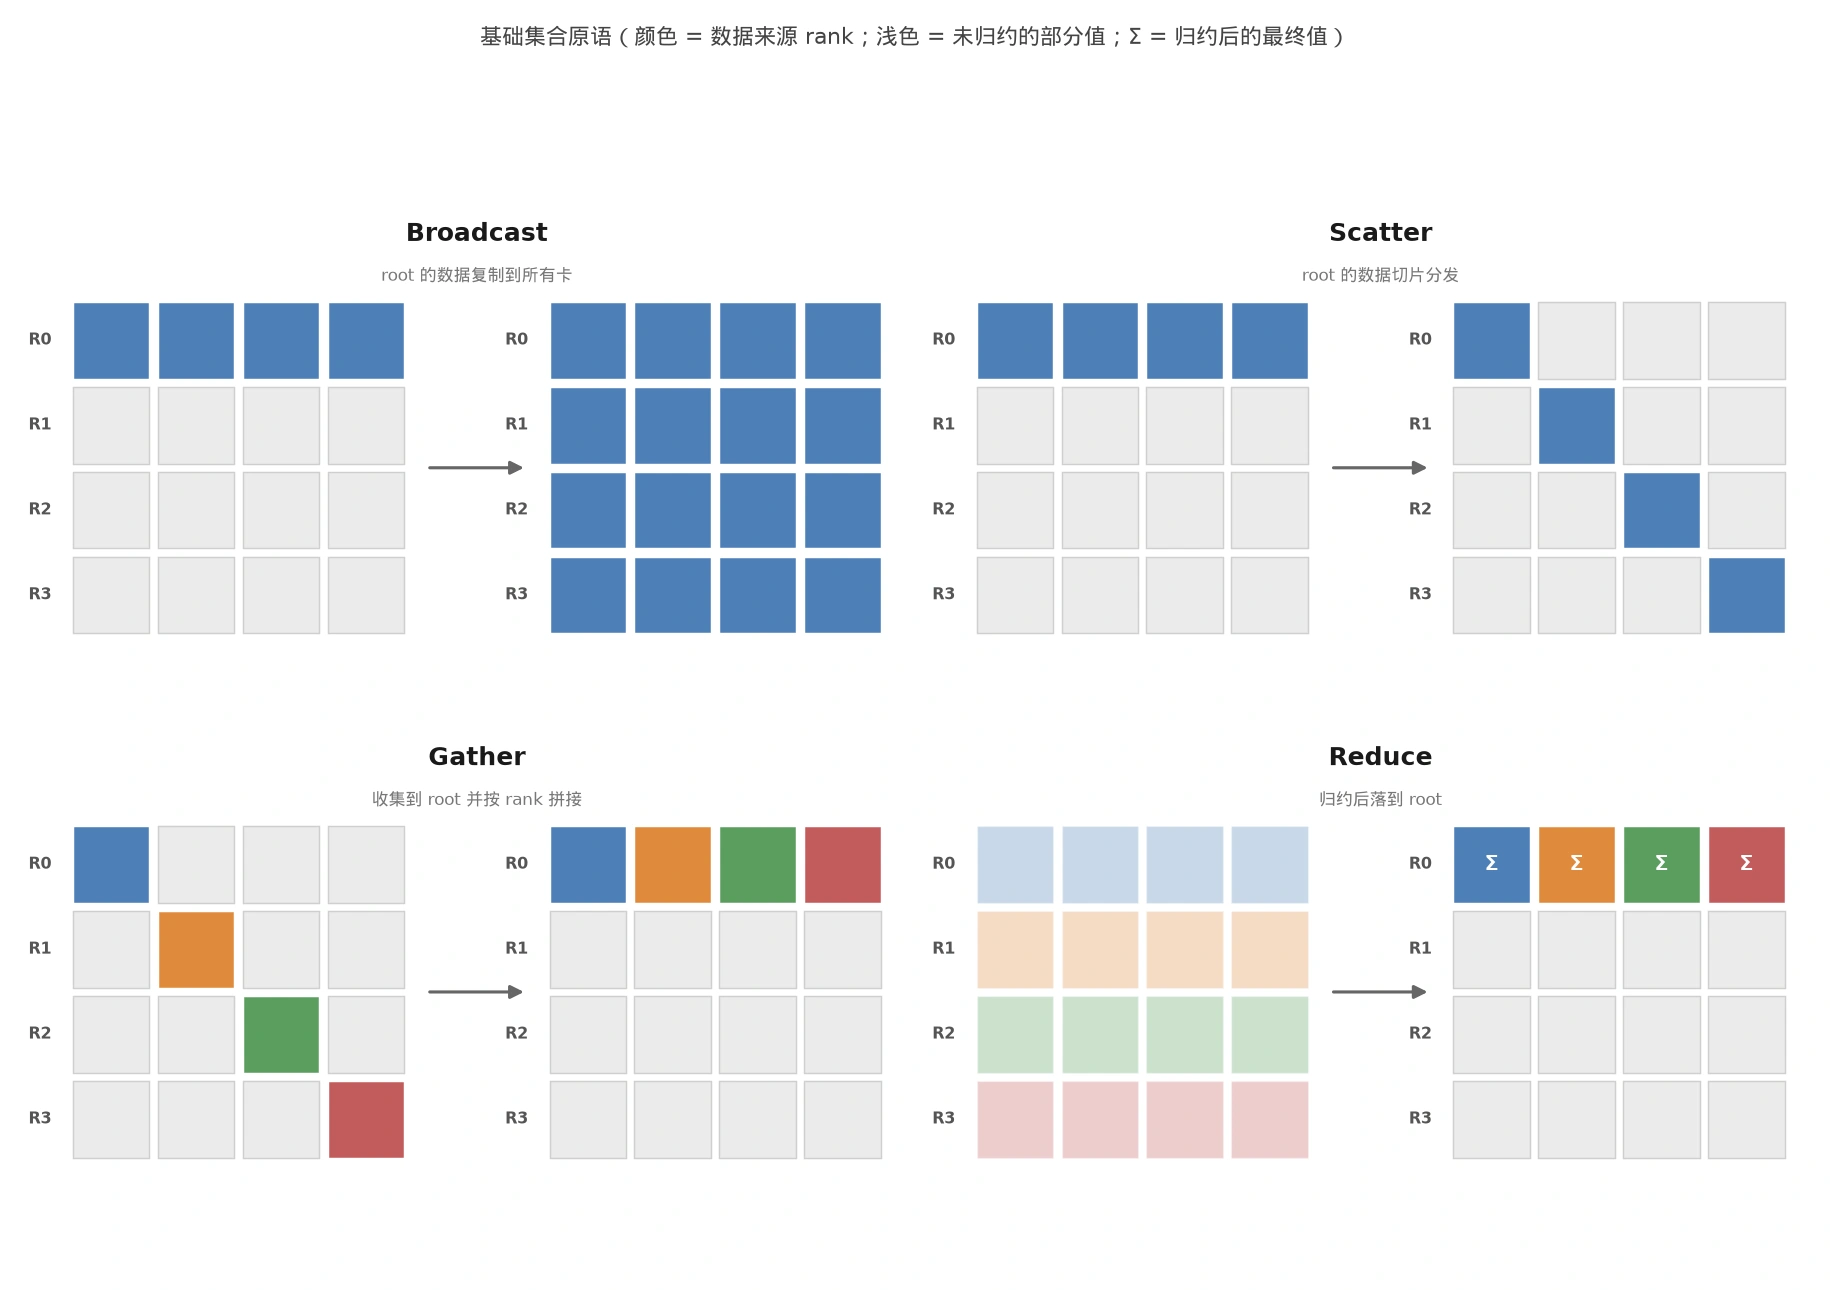
# Broadcast:root(src=0) 的值覆盖所有卡 —— 权重/超参下发buf = load_checkpoint() if rank == 0 else torch.empty_like(shape)dist.broadcast(buf, src=0)                    # 之后所有卡的 buf 完全一致
# Scatter:root 把完整张量按 rank 切片分发(scatter_list 只在 root 上有效)mine = torch.empty(1, dtype=torch.float64)scatter_list = [torch.tensor([float(i)], dtype=torch.float64)                for i in range(world_size)] if rank == 0 else Nonedist.scatter(mine, scatter_list=scatter_list, src=0)      # rank i 拿到第 i 片
# Gather:Scatter 的逆,各卡的份收拢到 root 拼接gather_list = [torch.empty(1, dtype=torch.float64)               for _ in range(world_size)] if rank == 0 else Nonedist.gather(mine, gather_list=gather_list, dst=0)
# Reduce:归约(默认 sum)后只落 root —— loss 归集total = mine.clone()dist.reduce(total, dst=0)                     # 只有 rank 0 拿到总和
四个原语的 root 都是瓶颈侧:root 需要收发 ,非 root 只收发 。环形实现下每卡总发送量都不超过 ——和全员原语同量级,但结果只有一个 rank 拿到(Reduce/Gather)或只有一个 rank 出发(Broadcast/Scatter)。
broadcast 在工程里最常见的出场是集群初始化:rank 0 从 checkpoint 恢复(或随机初始化)一份权重,广播给其他卡,保证所有副本从同一起点出发——ZeRO/FSDP 里每个参数分片的 owner 也用它对 padding、形状元数据达成一致。scatter/gather/reduce 在训练主循环里戏份不多(数据下发走 DataLoader 的 shard 采样,日志走 all_gather 居多),但它们是理解下一节全员原语的最好垫脚石:把 root 的特权去掉、让所有 rank 都拿到结果,就是 All- 系列。
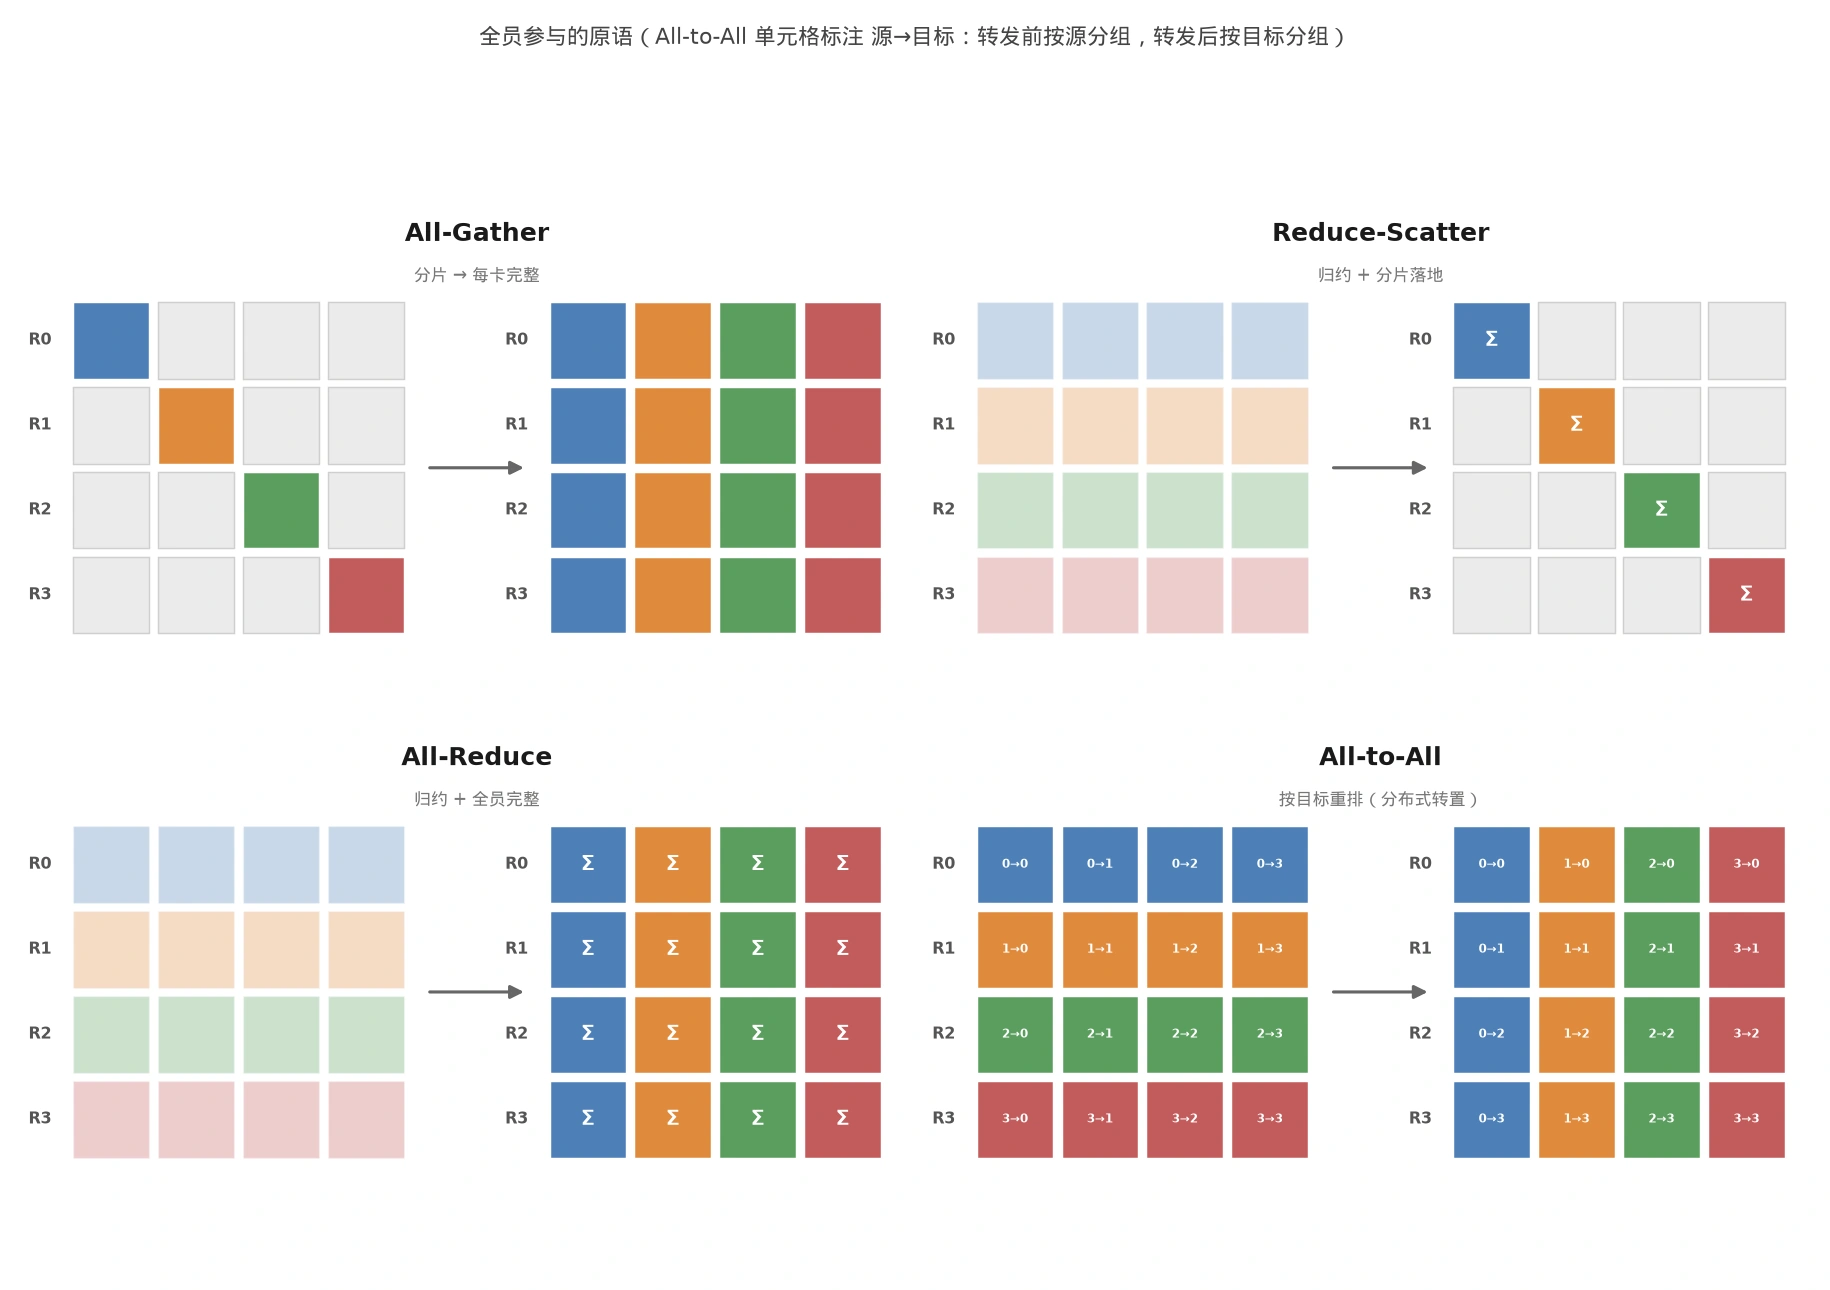
四、全员参与:All-Gather / Reduce-Scatter / All-Reduce
现代并行策略的主力原语。共同点:没有 root, 个 rank 对称参与,结束时各自拿到自己需要的那份结果。
4.1 All-Gather
每卡持有 分片,结束后每卡持有完整 。「只拼不加」——数据原样搬运。
shard = param_shard() # 本卡持有 1/Mfull = torch.empty(world_size * shard.numel(), dtype=shard.dtype)dist.all_gather_into_tensor(full, shard) # 拼回完整参数注意 API 的演化:老接口 all_gather(tensor_list, tensor) 要你先建好一个装 Tensor 的 list;新接口 all_gather_into_tensor(out, in) 直接写进一块预分配的连续显存——FSDP 里参数聚合用的是后者,省一次拷贝和一堆小对象。
LLM 场景:ZeRO-3 / FSDP 的前向取参。参数平时按 分片驻留,算到某层前把这层参数 AG 出来,算完即弃;Megatron 序列并行里激活进 TP 区域前的拼接也是 AG。
4.2 Reduce-Scatter 与前后向对偶
每卡持有 partial 值(各算各的、还没归约),结束后每卡持有归约结果的一个 分片。「只加不拼」。
grad_shard = torch.empty(grad_flat.numel() // world_size, dtype=grad_flat.dtype)dist.reduce_scatter_tensor(grad_shard, grad_flat) # 归约+分片一步到位grad_shard /= world_size # 平均 —— FSDP 在这里就地更新LLM 场景:ZeRO-2 梯度同步、FSDP 反向——梯度算出来是 partial 的,RS 完每卡只剩自己负责那 的均值梯度,直接就地更新,全量梯度从不物化。
AG 和 RS 互为前后向对偶:前向用 AG 的算子,反向梯度流过去就是 RS(各 rank 的梯度要累加再分发回分片);反之亦然。Scatter↔Gather、Broadcast↔Reduce 同样互为对偶;AR 和 A2A 的反向是自身。读 Megatron 论文里的通信模式时,这个对偶关系能让你只看前向就推出反向。
4.3 All-Reduce = Reduce-Scatter + All-Gather
AR 的语义一句话:归约 + 全员拿全量。关键洞察是它不是原子操作,而是两个半步的组合:
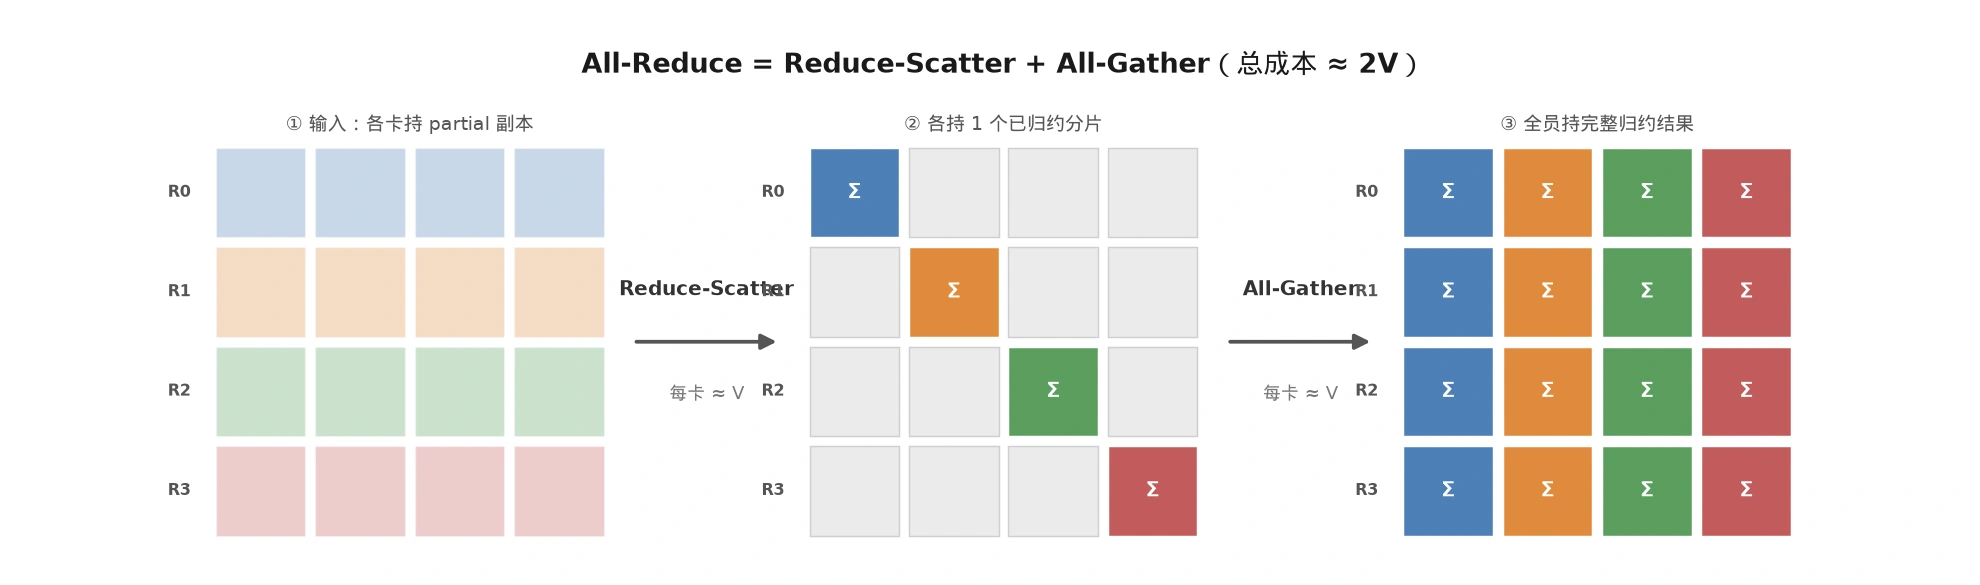
这句恒等式可以当场用代码验证:
x = torch.arange(2 * world_size, dtype=torch.float64) + 100 * rank  # 各卡 partial
shard = torch.empty(2, dtype=torch.float64)dist.reduce_scatter_tensor(shard, x)                # 半步 1:RSvia_two_step = torch.empty(2 * world_size, dtype=torch.float64)dist.all_gather_into_tensor(via_two_step, shard)    # 半步 2:AG
direct = x.clone()dist.all_reduce(direct)                             # 直接 ARassert torch.equal(via_two_step, direct)            # AG(RS(x)) == AR(x) ✓
字节账:RS 每卡搬 ,AG 再搬 ,AR 总共 。这个恒等式是 ZeRO/FSDP 整个设计空间的起点——把 AR 拆开,两个半步就能在训练 step 的不同时刻分别执行:RS 在拿到 partial 数据时立刻做,AG 推迟到真正要算全量时再做;甚至有些地方数据可以一直保持分片,AG 整个省掉。
LLM 场景:DDP 梯度同步、Tensor Parallel 每层前向的 g 投影和反向的 o 梯度。
一个数量级感受:7B 模型 bf16 梯度 GB,32 卡 AR 每卡搬 GB,200 GB/s 有效带宽下 ms——每步训练凭空多出一百多毫秒,这就是梯度 bucketing 和通信重叠存在的原因。
环形算法下 AR 需要 步,每步每卡传 。按 α-β 模型:
时带宽项收敛到 ,与卡数无关——这是 ring all-reduce 能撑起大规模训练的根本性质。 大、 小时延迟项占主导,换 tree 算法( 步)更划算,NCCL 按消息大小自动切换。
五、All-to-All:分布式转置
A2A 和前三个全员原语不同族:它不归约也不收集全量,而是重排。每卡持有一份按「目标」切好的数据(第 块发给 rank ),结束后换成按「来源」收好的数据(第 块来自 rank )——整个矩阵做了一次转置(见上图右下面板)。
等长的 A2A 一个函数搞定:
send = stack([块_for_rank_0, 块_for_rank_1, ...]) # 第 j 块发给 rank jrecv = torch.empty_like(send)dist.all_to_all_single(recv, send) # 转置后: recv[i] 来自 rank i但 MoE 真实的难点是变长(ragged):每个 token 去哪个专家由 router 运行时决定,各卡收发量天然不均。NCCL/all_to_all_single 只接受等长块,所以工程上是三步走——先 A2A 交换元数据,再 padding 到统一长度做等长 A2A,最后按元数据剥掉 padding:
# ① 元数据交换:发往各卡的 token 数(各卡不同 → 先同步计数)counts = torch.bincount(router, minlength=world_size)   # 本卡发往各卡的量in_counts = torch.empty(world_size, dtype=torch.long)dist.all_to_all_single(in_counts, counts)               # 收到: 各卡发给我的量
# ② padding 到统一容量 cap = max(counts),做等长 A2A(dispatch)cap = int(counts.max() 全局同步)send = torch.zeros(world_size, cap, d)                  # 按目标分组 + 补零for j in range(world_size):    send[j, :counts[j]] = tokens[router == j]recv = torch.empty_like(send)dist.all_to_all_single(recv, send)                      # 现在 recv[j] = 来自卡 j
# ③ 专家计算后原路转置回去(combine),按 in_counts 剥掉 padding 还原 token 顺序
LLM 场景首推 MoE 的 expert dispatch/combine:dispatch A2A 把 token 从「按所在卡分组」转置成「按专家分组」,专家算完,combine A2A 转置回去,残差相加,继续下一层。
字节账:设每卡激活 (自己的 token 数 × hidden × dtype 字节),每卡发送 ,收发同量。8 卡、每卡 4096 token、hidden 4096、bf16: MB,每次 A2A 发 MB,一层 dispatch+combine 共 MB,60 层就是每卡 ~3.4 GB/step——MoE 训练通信常常是主导成本,此言不虚。
A2A 的两个特殊难点:
- ragged(变长):见上——元数据交换 + padding 是通用解法,但 padding 浪费带宽、容量预估引入同步开销。DeepEP 直接用 NVSHMEM + RDMA 绕过 NCCL,让每对 rank 独立传不等长块,low-latency 模式下连 CUDA kernel 都不用提前下发。
- 对拓扑敏感:它是 条独立点对点流,不像 ring 有固定模式可套。
第二场景:DeepSpeed-Ulysses 式序列并行——attention 头分布在各卡,用两次 A2A 把序列维分片转置成头维分片。AG/RS 是「复制/归约」型切分,A2A 是「交换」型切分,MoE 和 Ulysses 都属于后者。
六、通信组:同一集群,多套并行各玩各的
真实训练同时叠加 TP × DP × PP,一次 init_process_group 建的是世界组,各维并行用 new_group 切出子组,集合通信只在子组内发生:
tp_size = 2tp_group = dist.new_group(ranks_for_this_tp_column)   # 如 [0,1] 和 [2,3]dp_group = dist.new_group(ranks_for_this_dp_row)      # 如 [0,2] 和 [1,3]
x = torch.full((2,), float(rank))t, d = x.clone(), x.clone()dist.all_reduce(t, group=tp_group)   # 只和 TP 组内的邻居归约dist.all_reduce(d, group=dp_group)   # 同一张量,DP 组内另一个结果
4 卡实例:R0 在 TP 组 [0,1] 里归约得 1.0,在 DP 组 [0,2] 里归约得 2.0——同一个 all_reduce 调用,group 参数决定它属于哪条并行维。Megatron-LM 初始化时就把 tp/dp/pp 三套 group 全建好,层里的每个集合调用都显式传 group=。
七、工程视角:这些调用长在框架的哪里
知道原语语义之后,读框架源码的钥匙就一句话:每个并行策略 = 把策略特有的张量切分,翻译成固定的原语序列。
- DDP(
torch/nn/parallel/distributed.py→Reducer):反向传播逐参数产生梯度,Reducer 按 25 MB 默认 bucket 聚合,bucket 一满就发射一次all_reduce——所以 DDP 的 AR 天然与 backward 重叠。register_comm_hook可以换成自定义实现(fp16 压缩、BF16、one-shot)。 - FSDP / ZeRO-3(
torch/distributed/fsdp/):参数以FlatParameter平铺分片。forward 前对当前 unitall_gather_into_tensor取参(prefetch会提前一层发起),反向结束对梯度reduce_scatter_tensor——正是 4.1/4.2 那两个 API。从代码里 grep 这两个函数名,通信路径一目了然。 - Megatron TP:
RowParallelLinear前向all_reduce(g/o 投影的 partial 输出),ColumnParallelLinear反向all_reduce(grad wrt input)——每层 2×AR 的出处。开 SP 后换成gather/scatter(AG/RS),藏在_gather/_split辅助函数里。 - vLLM / SGLang TP 推理:每层 attention 后
all_reduce,小 batch 时走自定义custom_all_reduce(NVLink 域内 one-shot,绕过 NCCL 的启动开销),大张量回落 NCCL。 - DeepEP:dispatch/combine 的变长 A2A,NVSHMEM 实现,框架侧只调
dispatch()/combine()两个入口。
八、亲手跑一遍
把上面的片段串成一个完整脚本(约 100 行,无外部依赖),覆盖六个实验:PP 双向点对点、root 族四件套、AG∘RS ≡ AR 恒等式、ragged MoE dispatch/combine 往返、TP/DP 双通信组、DDP 与 Zero-2 的等价更新:
"""comm_primitives_demo.py — torch.distributed 通信原语可运行演示CPU + gloo 即可运行(无需 GPU):    torchrun --nproc-per-node=4 comm_primitives_demo.py"""import osimport torchimport torch.distributed as dist
R = int(os.environ["RANK"])W = int(os.environ["WORLD_SIZE"])dist.init_process_group("gloo")torch.manual_seed(0)  # 所有 rank 同种子 → 同初始化
def log(msg):    if R == 0:        print(f"[R0] {msg}", flush=True)
def head(s):    if R == 0:        print(f"\n=== {s} ===", flush=True)
# ---------- 1. Send/Recv: 模拟 PP 相邻 stage ----------head("1. Send/Recv — 流水线: 激活向右, 梯度向左")act = torch.tensor([float(R + 1), 0.0])recv_l, recv_r = torch.zeros(2), torch.zeros(2)if R > 0:    dist.recv(recv_l, src=R - 1, tag=10)                    # 收上游激活if R < W - 1:    dist.send(act, dst=R + 1, tag=10)                       # 激活发下游if R < W - 1:    dist.recv(recv_r, src=R + 1, tag=20)                    # 收下游梯度if R > 0:    dist.send(torch.tensor([1.0, 1.0]), dst=R - 1, tag=20)  # 梯度发上游log(f"stage{R}: 上游激活={recv_l.tolist()} 下游梯度={recv_r.tolist()}")
# ---------- 2. root 族 ----------head("2. Broadcast / Scatter / Gather / Reduce")b = torch.arange(4, dtype=torch.float64) + R * 100dist.broadcast(b, src=0)assert torch.equal(b, torch.arange(4, dtype=torch.float64))
mine = torch.empty(1, dtype=torch.float64)src = [torch.tensor([float(i)], dtype=torch.float64) for i in range(W)] if R == 0 else Nonedist.scatter(mine, scatter_list=src, src=0)                 # rank i 拿到第 i 片assert mine.item() == R
gathered = [torch.empty(1, dtype=torch.float64) for _ in range(W)] if R == 0 else Nonedist.gather(mine, gather_list=gathered, dst=0)if R == 0:    assert [g.item() for g in gathered] == list(range(W))
red = mine.clone()dist.reduce(red, dst=0)if R == 0:    assert red.item() == sum(range(W))log("broadcast/scatter/gather/reduce 断言全部通过")
# ---------- 3. 全员族 + AR = RS + AG ----------head("3. All-Gather / Reduce-Scatter / All-Reduce")inp = torch.arange(2 * W, dtype=torch.float64) + 100 * R    # 每卡一份 partialshard = torch.empty(2, dtype=torch.float64)dist.reduce_scatter_tensor(shard, inp)                      # RS: 各持 1/W 归约分片full = torch.empty(2 * W, dtype=torch.float64)dist.all_gather_into_tensor(full, shard)                    # AG: 分片拼回完整ref = inp.clone()dist.all_reduce(ref)                                        # 直接 AR 做对照assert torch.equal(full, ref)                               # AG(RS(x)) == AR(x)log(f"RS 分片={shard.tolist()}, 恒等式 AG(RS(x)) == AR(x) 成立 ✓")
# ---------- 4. All-to-All: mini MoE dispatch/combine ----------head("4. All-to-All — MoE dispatch/combine (ragged 变长)")g = torch.Generator().manual_seed(100 + R)n_tok = 2tok = torch.randn(n_tok, 2, generator=g)                    # 本卡 tokenrouter = torch.randint(0, W, (n_tok,), generator=g)         # token → 专家 → 卡counts = torch.bincount(router, minlength=W)                # 发往各卡的量(不均!)
in_counts = torch.empty(W, dtype=torch.long)dist.all_to_all_single(in_counts, counts)                   # ① 元数据交换cap_t = torch.tensor([int(counts.max())], dtype=torch.long)dist.all_reduce(cap_t, op=dist.ReduceOp.MAX)                # 全局最大容量cap = int(cap_t)
send = torch.zeros(W, cap, 2)                               # ② 按目标分组 + paddingfor e in range(W):    rows = tok[router == e]    send[e, : rows.shape[0]] = rowsrecv = torch.zeros(W, cap, 2)dist.all_to_all_single(recv, send)                          # 等长 A2A
send2 = torch.zeros(W, cap, 2)                              # ③ 本地"专家"= *10, 转置回去for j in range(W):    send2[j, : int(in_counts[j])] = recv[j, : int(in_counts[j])] * 10recv2 = torch.zeros(W, cap, 2)dist.all_to_all_single(recv2, send2)final = torch.empty(n_tok, 2)                               # ④ 按 router 还原顺序for e in range(W):    idx = (router == e).nonzero().squeeze(1)    final[idx] = recv2[e, : len(idx)]assert torch.allclose(final, tok * 10)log(f"router={router.tolist()} 发送计数={counts.tolist()} (ragged), "    f"dispatch→expert→combine 往返后 == tok*10 ✓")
# ---------- 5. new_group: TP × DP 子组 ----------head("5. new_group — 同一集群, TP/DP 各自的通信组")tp_size = 2tp_g = [dist.new_group([0, 1]), dist.new_group([2, 3])]dp_g = [dist.new_group([0, 2]), dist.new_group([1, 3])]tp, dp = tp_g[R // tp_size], dp_g[R % tp_size]a = torch.full((2,), float(R))t, d = a.clone(), a.clone()dist.all_reduce(t, group=tp)dist.all_reduce(d, group=dp)log(f"TP 组内和={t.tolist()} DP 组内和={d.tolist()} (同一张量, 两个组两个结果)")
# ---------- 6. DDP vs Zero-2: 同一笔 2V 通信账的两种花法 ----------head("6. DDP vs Zero-2 — AR 的两种花法")lin = torch.nn.Linear(8, 8, bias=False)                     # 同初始化gd = torch.Generator().manual_seed(1000 + R)x = torch.randn(2, 8, generator=gd)                         # 各卡不同数据(DP)lin(x).pow(2).sum().backward()lr = 0.1
g = lin.weight.grad.clone()                                 # DDP: 梯度 AR + /Wdist.all_reduce(g)g /= Wp_ddp = lin.weight.data - lr * g
flat = lin.weight.grad.reshape(-1)                          # Zero-2: RS 分片n = flat.numel()shard = torch.empty(n // W)dist.reduce_scatter_tensor(shard, flat)shard /= Wp_local = lin.weight.data.reshape(-1)[R * n // W : (R + 1) * n // W] - lr * shardp_full = torch.empty(n)dist.all_gather_into_tensor(p_full, p_local)                # 参数 AG 重建assert torch.allclose(p_full, p_ddp.reshape(-1))log(f"64 参数: DDP 每卡常驻 64 梯度+64 优化器态; Zero-2 每卡只持 {n // W}; "    f"两条路径更新结果一致 ✓ (通信量同为 2V)")
dist.destroy_process_group()
实测输出(PyTorch 2.9.1、gloo、torchrun --nproc-per-node=4):
=== 1. Send/Recv — 流水线: 激活向右, 梯度向左 ===[R0] stage0: 上游激活=[0.0, 0.0] 下游梯度=[1.0, 1.0]
=== 2. Broadcast / Scatter / Gather / Reduce ===[R0] broadcast/scatter/gather/reduce 断言全部通过
=== 3. All-Gather / Reduce-Scatter / All-Reduce ===[R0] RS 分片=[600.0, 604.0], 恒等式 AG(RS(x)) == AR(x) 成立 ✓
=== 4. All-to-All — MoE dispatch/combine (ragged 变长) ===[R0] router=[2, 0] 发送计数=[1, 0, 1, 0] (ragged), dispatch→expert→combine 往返后 == tok*10 ✓
=== 5. new_group — 同一集群, TP/DP 各自的通信组 ===[R0] TP 组内和=[1.0, 1.0] DP 组内和=[2.0, 2.0] (同一张量, 两个组两个结果)
=== 6. DDP vs Zero-2 — AR 的两种花法 ===[R0] 64 参数: DDP 每卡常驻 64 梯度+64 优化器态; Zero-2 每卡只持 16; 两条路径更新结果一致 ✓ (通信量同为 2V)
实验 6 值得多看一眼:DDP 和 Zero-2 走的显式路径完全不同(AR vs RS+AG),但每卡通信量同为 ,最终参数也逐位一致——差的只是梯度和优化器状态的驻留方式(DDP 每卡常驻全量,Zero-2 只驻 分片)。这就是「ZeRO-2 相对 DDP 免费省显存」的代码级证明。
九、成本速查与场景对照
| 原语 | 起始持量 | 每卡发送量 | 结束持量 | LLM 典型场景 |
|---|---|---|---|---|
| Send/Recv | 任意 | — | PP 激活/梯度传递、PD 分离 KV 传输(RDMA) | |
| Broadcast | root: | (root) | 权重初始化、超参下发 | |
| Scatter | root: | (root) | 数据切分下发 | |
| Gather | root: | 日志/指标聚合 | ||
| Reduce | (partial) | root: | loss 归集 | |
| All-Gather | ZeRO-3 取参、SP 进 TP 区 | |||
| Reduce-Scatter | (partial) | ZeRO-2 梯度、SP 出 TP 区 | ||
| All-Reduce | (partial) | DDP 梯度同步、TP 层内同步 | ||
| All-to-All | (自己的份) | MoE dispatch/combine、Ulysses SP |
反过来查——每个并行策略用到什么:
| 并行策略 | 通信原语 |
|---|---|
| DDP | 反向 AR 梯度(bucket 化 + 与反向重叠) |
| ZeRO-1/2 (FSDP) | 梯度 RS + 更新后参数 AG |
| ZeRO-3 (FSDP full) | 前向/反向参数 AG + 梯度 RS, |
| Tensor Parallel | 每层 2× AR(或 SP 改造后的 AG+RS) |
| Sequence Parallel | 进 TP 区 AG、出 TP 区 RS(Megatron);或 2× A2A(Ulysses) |
| Pipeline Parallel | 相邻 stage 点对点 Send/Recv |
| Expert Parallel (MoE) | 每层 2× 变长 A2A |
十、实践要点
Megatron 序列并行的账。TP 每层两个 AR 共 (前向 g + 反向 o 各一次,正反向合计),SP 把它们换成 AG+RS 组合——总字节不变,换来两个好处:LN/dropout 的激活也按序列维分片(激活显存 ÷ M),且两个半步的集合通信更容易和前后 GEMM 重叠。
ZeRO 的账。论文口径:Z1/Z2 通信量与 DDP 相当(),Z3 为 (前向 AG + 反向重取 AG + 梯度 RS),贵 50%。买的是显存:参数、梯度、优化器状态全部 ÷ M。
算法与协议由库自动选。NCCL 按 message size 和拓扑在 ring(大消息、带宽最优)/ tree(小消息、 步延迟最优)/ NVLS(NVSwitch 网内归约)之间切换,协议层另有 Simple/LL/LL128 三档。vLLM 的 custom_all_reduce 是单机 NVLink 域内小消息的 one-shot 实现;PyTorch symmetric memory 提供同类能力,RL roll out 的 weight sync、eager 推理的小张量同步受益明显。手动设 NCCL_ALGO 只该用于 A/B 实验。
常见陷阱(前两条本文示例都真实踩到/触发过):
- dtype/shape 必须逐位一致。
dist.scatter里 scatter_list 的元素是 float32、目标张量是 float64 时,gloo 的报错是一句晦涩的Invalid usage of tensors with different dtypes,而其他 rank 看到的则是Connection closed by peer——先挂的 rank 把同伴拖死,日志里真正的错误只有一行。新式*_tensorAPI 把 dtype 检查提前了,但仍要自己保证。 - 集合通信要求所有 rank 以相同顺序调用相同算子——某张卡走了不同分支(条件语句、动态 batch 路径),其他卡会在下一个集合调用处永远等待,表现为随机 hang。用
NCCL_DEBUG=INFO+TORCH_DISTRIBUTED_DEBUG=DETAIL定位,timeout=参数给 init_process_group 设兜底。 - 逐参数发小消息是延迟灾难:DDP 默认 25 MB bucket 聚合再 AR;FSDP 逐层 RS 时,特别薄的层可能掉到延迟主导区间。
- 机内 NVLink 与机间 IB 带宽差近一个量级,跨机集合通信走层级化算法(先机内归约再跨机);排通信时优先让大流量留在机内。
十一、小结与下一篇
九个原语、三句话记全:root 族(Broadcast/Scatter/Gather/Reduce)围绕一个中心, 的流量,现代 LLM 负载里戏份不多;全员复制族(AG/RS/AR)是并行策略的主体,AG 只拼、RS 只加、AR = RS + AG ;A2A 独立成族,做转置不做归约,MoE 时代从配角升为主角。
下一篇深入算法内部:ring 的逐步推演与为什么带宽项与 无关、tree/NVLS 的适用边界、NCCL 的 channel 与协议机制、通信-计算重叠的具体手法、DeepEP 的变长 A2A。
参考资料
- NCCL 文档:Collective Operations — 各原语官方定义
- PyTorch Distributed 文档 — 本文所有 API 的权威出处(
all_gather_into_tensor/reduce_scatter_tensor等新式接口) - Roman Vorushin: TPU/GPU collective primitives — 本文 before/after 图示思路的来源,含环上逐块动画
- Aleksa Gordic: Inside TPU and GPU Clusters — 集合操作与集群拓扑的完整图景
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models — Z1/Z2/Z3 通信量账本
- Reducing Activation Recomputation in Large Transformer Models — Megatron 序列并行的 AG/RS 改造
- Demystifying NCCL — NCCL 内部协议与算法的源码级分析